Context-Function 기반의 기술 활용 시나리오 기회 식별
© 2026 KIIE
Abstract
Technology opportunity discovery strategies play an important role in the success of R&D. Numerous studies have analyzed the functional information of technology using patent data, however, few have considered the context in which these functions are applied, thereby overlooking the varying value of a technology depending on its application. Thus, this study proposes a context-aware approach for discovering technology opportunities in the form of ‘technology use scenarios’ by analyzing both context and function information. The proposed approach involves: 1) collecting patent data; 2) extracting context and function expressions; 3) defining technology use scenarios by linking context-function clusters; 4) identifying technology opportunities by constructing a Scenario Opportunity Map that evaluates R&D Activity and technological impact. A case study on autonomous vehicle technology was conducted to verify the applicability of the proposed approach. Technology opportunities identified at the scenario level can contribute to establishing more concrete development directions for technology planning.
Keywords:
Patent Analysis, Context-Function Analysis, Technology Opportunity Discovery, Large Language Model, Technology Use Scenario1. 서 론
기술 중심 산업에서 R&D는 기술 분야의 방향성을 좌우하는 핵심적인 활동이며, 어떤 기술 기회 발굴(Technology Opportunity Discovery, TOD) 전략을 취하는지는 R&D의 성공 가능성과 직결된다(Lee et al., 2017). 기업과 연구자는 R&D의 우선순위를 정하고 최적의 기술 개발 방향을 설정하기 위해 TOD에 막대한 노력을 기울이고 있다(Park and Yoon, 2018). TOD는 투자 가치가 있는 기술 분야를 찾는 것만이 아니라, 소비자가 완성된 제품이나 서비스를 실제로 이용하는 상황에 따라 달라지는 구체적인 요구 사양과 기능을 최적화하는 과정까지 모두 포괄하는 의미이다(Wang et al., 2024). 즉, TOD의 궁극적인 목표는, 잠재적 기술 탐색보다 새로운 가치 창출을 실현할 수 있는 기반을 마련하는 데 있다(Lee, 2011).
TOD 연구에서는 특허, 논문, 시장 보고서 등 다양한 정보가 활용된다. 특히 R&D의 산출물인 특허는 기술에 대한 상세하고 표준화된 정보를 담고 있어, TOD 과정에서 핵심적인 정보 자원으로 활용된다(Paula and Silva, 2021). 특허에는 기술의 기능이나 구현 원리뿐만 아니라, 기술 개발 배경이나 활용 방안과 같은 맥락적 정보까지 포함되어 있다. 따라서 기술이 활용되는 상황에 따라 달라질 수 있는 다양한 시사점을 도출할 수 있다(Ree et al., 2019). 이처럼, 특허가 제공하는 풍부한 기술 정보는 TOD 활동에 폭넓게 활용될 수 있다는 점에서 가치가 더욱 높다.
특허 분석을 통한 TOD에는 서지 지표 분석, 네트워크 분석 등 다양한 접근법이 존재한다(Cammarano et al., 2024; Roh et al., 2019; Wang et al., 2024). 그중 본 연구에서는 기술이 수행하는 핵심적인 역할로 정의되는 Function을 분석하는 연구들에 주목한다. 선행 연구들은 특허 문서로부터 기술의 Function 정보를 추출하고, 이를 기반으로 SAO(Subject-Action-Object) 분석, Function Network 구축 등 여러 방식을 통해 기술 분야의 구조를 파악하거나 유망 기술 분야를 예측하고자 하였다(Park et al., 2014; Qiao et al., 2025). 또한, 일부 연구들은 발굴된 기술 기회 후보들을 대상으로 정량적 지표 분석이나 포트폴리오 맵 등을 통해 우선순위를 정하는 방법을 제시하였다(Moon and Lee, 2024; Roh et al., 2019). 기술의 Function 정보는 기술이 해결하고자 하는 근본적인 목적을 담고 있기 때문에, Function 정보를 분석하는 접근은 기술의 본질을 통해 유망한 기술 영역을 탐색하는 데 유용하게 활용될 수 있다(Mun et al., 2021).
기술의 Function 정보를 분석하는 연구들이 가진 학술적 의의에도 불구하고, 종래의 Function 분석 TOD 연구들은 다음과 같은 두 가지 한계점을 가진다. 첫째, Function을 분석하는 접근만으로는 그 Function이 어떤 Context에서 활용되는지는 고려하기 어렵다. 기술은 활용처에 따라 그 의미와 가치가 크게 달라진다(Kim et al., 2019). 예를 들어, 자동차 기술의 ‘센서 신호 정밀 제어’라는 Function은 ‘GPS 통신 불량’과 ‘돌발 상황 발생’이라는 각기 다른 두 Context에서 전혀 다른 의미를 가질 수 있다. GPS 통신 불량 상황에서 이 Function은 터널이나 지하 주차장처럼 GPS 신호가 원활하지 않은 환경에서 차량 내부의 다른 센서 정보를 융합하여 차량의 위치를 추정하는 역할을 한다. 이때 대상 기술의 목표는 ‘위치 정확도 유지’가 된다. 반면, 돌발 상황에서 ‘센서 신호 정밀 제어’ Function은 위험 신호를 정확하게 감지하여 비상 제동을 돕는 역할을 한다. 이때에는 정확한 위기 감지를 위한 ‘센서 신뢰도 확보’가 최우선으로 요구된다. 이처럼 Context 정보가 결여된 Function 분석은 발굴된 기술 기회의 실질적인 활용 방안을 탐색하기 위한 또 다른 비용을 야기할 수 있다(Lee et al., 2021). 완성도 높은 기술이라도 명확한 활용처를 찾지 못하면 그 가치를 실현할 수 없기 때문에, 기술 자체의 우수성뿐만 아니라 기술이 활용되는 Context 또한 고려하는 접근이 필요하다. 둘째, 기술 기회 후보를 정량적으로 평가하거나 시각화하기 위한 다양한 시도가 이루어졌으나, 기존의 방법들은 Function이 어떤 Context에서 수행되는지에 따른 기회 수준의 차이를 계량적으로 식별하지 못하였다. 앞선 예시에서 ‘GPS 통신 불량 상황에서 센서 신호 정밀 제어 Function’ 시나리오는 이미 많은 개발을 통해 충분히 해결되었을 수 있지만, ‘돌발 상황 발생 시 센서 신호 정밀 제어 Function’ 시나리오는 시급히 해결되어야 할 기술 기회일 수 있다. 즉, 유사 기술이라도 기술이 활용되는 시나리오에 따라 기회 수준은 전혀 다르게 나타날 수 있으며, 이를 식별하지 못하면 이미 발전한 기술을 기회로 오인할 수 있다. 특정 기술 분야를 대상으로 한 TOD에서 많은 연구를 통해 이미 고도화된 기술은 새로운 기회로 보기 어려우므로, 중요하지만 상대적으로 완성도가 낮은 기술을 찾고자 하는 접근이 필요하다.
따라서 본 연구는 기술의 Function과 Context를 종합적으로 고려하기 위해, ‘기술 활용 시나리오’를 분석 단위로 하는 TOD 방법론을 제안한다. 본 연구에서 Context는 ‘기술이 적용되는 영역을 구성하는 상황적, 환경적 속성의 집합’으로 정의되며 위치, 시간, 활동, 현상, 상태 등의 정보를 포함한다. 기술 활용 시나리오는 Context와 Function 정보를 쌍(Pair)으로 연결한 것으로, ‘GPS 통신 불량 상황에서 센서 신호 정밀 제어’와 같이 기술이 특정 Context에서 어떤 역할을 수행하는지를 나타낸다. 기술 활용 시나리오에서는 Function이 동일하더라도 Context가 달라지면 다른 시나리오로 간주되어, Context에 따라 달라지는 기회 수준을 포착할 수 있도록 한다. 본 연구는 기술 활용 시나리오를 통해 Context 정보를 포함함으로써, 보다 구체적인 개발 방향을 제시할 수 있는 기술 기회를 도출하도록 한다. 본 연구에서 제안하는 방법은 1) 국내 출원 특허 데이터를 수집하고, 2) 수집한 특허 텍스트로부터 Context 및 Function 표현을 추출한 뒤, 3) 클러스터링을 통해 도출한 Context 및 Function 클러스터를 연결하여 기술 활용 시나리오를 정의한 다음, 4) Scenario Opportunity Map을 구축하여 R&D의 활동량이 높지만 기술적 파급력은 상대적으로 낮은 시나리오를 기술 기회로 식별한다. 제시하는 방법의 활용성을 확인하기 위해, 자율주행 자동차 기술 분야를 대상으로 사례연구를 실시한다.
본 연구의 기여점은 다음과 같다. 첫째, 본 연구는 기술의 Function과 기술이 활용되는 Context를 함께 분석하여 기술 활용 시나리오 형태의 기술 기회를 발굴하는 새로운 방법론을 제시한다. 특허 문서에서 기술의 Context 및 Function 표현을 함께 추출하여, Context-Function 쌍 형태를 가지는 기술 활용 시나리오를 정의함으로써 기술의 실질적인 활용처를 제시할 수 있다. 이를 통해 실제 R&D나 사업 전략 수립 시, 보다 구체적인 기술 개발 방향을 설정하는 데 기여할 수 있다. 둘째, 본 연구는 R&D의 활동량과 기술적 파급력을 동시에 고려하는 기술 기회 식별의 새로운 시각을 제시한다. R&D의 활동량이 높고 기술적 파급력은 낮은 기술 활용 시나리오는 각 지표를 축으로 하는 Scenario Opportunity Map을 통해 도출할 수 있다.
본 논문은 제2장에서 기술의 Function을 정의하고 활용한 연구를 소개하고, 제3장에서 연구의 구체적인 방법에 관하여 서술한 뒤, 제4장에서 자율주행 자동차 기술 분야를 대상으로 사례연구를 실시한다. 마지막으로 제5장에서 연구의 결론 및 추후 연구에 대해 기술한다.
2. Function Analysis Approaches for TOD
기술과 제품은 근본적으로 사용자가 원하는 Function을 제공하기 위해 존재하며, 특허 문서에서 기술의 Function 정보는 기술의 용도와 목적을 명확하게 담고 있다(Park et al., 2013). Function 분석 기반 TOD 연구에서 Function이란, 기술이 ‘무엇을 하는지’, 또는 ‘무엇을 위해 존재하는지’로 정의되며, 특정 목적을 달성하기 위한 본질적인 작용을 의미한다(Yoon et al., 2015). Function 분석은 기술 자체를 중심으로 분석하는 것보다 기술 개발의 목표를 더 직관적이고 유연하게 설정할 수 있는 기술 기회를 도출하는 데 유리하다(Song et al., 2019).
여러 선행 연구는 특허 문서로부터 기술의 Function을 추출하고 이를 활용하여 기술 기회를 발굴하고자 하였다. Park et al.(2014)은 특허 문서로부터 기술의 Function 정보를 추출하여 제품-기술-기능의 관계로 이루어진 TOD 지식베이스를 구축하고, Function 유사도를 바탕으로 4가지 유형의 TOD 시나리오를 정의함으로써 체계적인 기술 기회 발굴 경로를 제안하였다. Roh et al.(2017)은 특허 내 기술 정보를 기능·구성·운용방법 등 유형별로 문장을 구조화하고 계층화하는 기법을 제안하여, 텍스트 마이닝 과정에서 발생할 수 있는 Function 단서의 누락과 노이즈를 줄이는 데 기여하였다. Kim and Lee(2024)은 Function을 Action-Object 구조로 정의하고, 사전 학습된 언어 모델 기반의 준지도 학습 토픽 모델링을 적용하여, 이종 도메인 간의 의미적 유사성을 고려한 Function 기반의 기술 기회를 탐색하는 방법론을 제시하였다. Qiao et al.(2025)은 특허의 문장을 SAO 구조로 정형화하여 특허 문서에서 Technology-Function Pair를 추출하고, 기술의 잠재적 응용 분야를 발견하는 방법을 제시하였다. 나아가 특허 문서뿐만 아니라 사용자 데이터를 결합하거나 고도화된 분류 체계를 활용한 연구들도 수행되었다. Roh et al.(2019)은 사용자 리뷰에서 Opinion Trigger를 정의하여 니즈를 Function 수준으로 구조화하고 이를 특허 정보와 매칭함으로써, 시장의 요구를 반영한 해결형 및 공백형 기술 기회를 제시하는 데 효과적인 접근을 보여주었다. Song et al.(2017)은 JPO 특허의 상세 분류 체계인 F-term을 텍스트 마이닝과 결합하여 Function을 포함한 기술적 속성 간의 유사성을 탐색하고, 타 분야의 속성을 차용하는 조합을 통해 기술 기회를 도출하였다.
일부 연구에서는 Function 분석을 활용하여 식별된 기술 기회 후보들에 대해, 정량적 지표나 시각적 도구를 활용하여 기회 수준을 평가하고 우선순위를 설정하는 방법을 제안하였다. Ren and Zhao(2021)은 도메인 지식 네트워크를 구축하고 회귀 분석을 수행하여 기술 기회의 가치에 영향을 미치는 변수를 식별하여 우선순위를 결정하는 방법을 제시하였다. Ren et al.(2023)은 특허 데이터를 활용하여 기술 기회 평가 지표의 중요도를 도출하고, 구축한 평가 모델을 바탕으로 최적화 알고리즘을 적용하여 우선순위가 높은 기술 기회를 탐색하는 방법론을 제시하였다. Moon and Lee(2024)은 PFT(Product-Function-Technology) Portfolio Map과 Relationship Map을 구축하고, 빈도와 증가율을 토대로 현재 활용 중인 기회와 잠재적 기회의 우선순위를 결정하고자 하였다.
Function 중심의 기술 분석은 기술의 본질적인 역할을 분석함으로써 유망 기술 영역을 식별하는 데 유용하게 활용되어왔지만, 대다수의 기존 연구는 기술의 Function이 어떤 Context에서 활용되는지를 충분히 고려하지 못해, 활용처에 따른 기술의 가치 차이를 반영하지 못한다는 한계를 가진다. 예를 들어, 수많은 선행 연구에서 활용된 SAO 분석은 기술의 작동 주체, 동작, 대상은 포착할 수 있으나, 분석 대상 기술이 어떤 Context에서 사용되는지는 분석할 수 없다. 기술의 Function은 활용되는 Context에 따라 의미와 중요성이 달라지며, 같은 Function이라도 적용 분야에 따라 기회로서의 가치가 크게 변할 수 있다(Kim et al., 2019). 따라서 Function의 의미와 가치를 정확히 파악하기 위해서는 기술이 제품으로서 활용되는 구체적인 Context 정보 또한 함께 분석할 필요가 있다(Lee et al., 2023). 또한 정량적, 시각적 지표를 통해 기술 기회의 기회 수준을 평가한 연구들 역시, Function이 어떤 Context에서 실행되는지에 따른 기회 수준의 차이는 식별해 내지 못하기 때문에, 같은 Function이라도 적용되는 Context에 따라 구분하여 우선순위를 설정할 수 있는 식별 방법이 필요하다.
본 연구는 기존 연구의 한계를 보완하기 위해 Function과 Context를 함께 분석하는 TOD 프레임워크를 제안한다. 구체적으로 특허 문서에서 Context 및 Function 표현을 동시에 추출하여 Context-Function 쌍으로 구성된 기술 활용 시나리오를 정의하고, 이를 기술 기회의 기본 단위로 삼아 분석함으로써 Function이 ‘어디서, 언제, 누구에게, 어떤 조건에서’ 수행되는지를 함께 고려한다. 나아가 본 연구는 각 시나리오에 대해 R&D의 활동량과 기술적 파급력을 동시에 반영하는 Scenario Opportunity Map을 구축하여, 우선순위가 높은 기술 활용 시나리오를 식별하고자 한다. 이를 통해 종래의 Function 중심 TOD 연구가 제공하지 못했던 Context를 포함한 기술 기회 탐색과, 기술기획 활동에 활용할 수 있는 구체적인 개발 방향 제시라는 측면에서 이론적·실무적 기여를 하고자 한다.
3. 연구 방법
본 연구가 제시하는 분석 방법은 <Figure 1>의 절차를 따른다. 1) 우선, 특정 분야의 특허 데이터를 수집하고, 2) 대규모 언어 모델 기반 프롬프트 엔지니어링을 통해 Context, Function 표현을 추출한다. 3) 추출된 Context, Function 표현에 대해 각각 클러스터링 후 기술 활용 시나리오를 정의한다. 4) 마지막으로, 도출된 시나리오의 우선순위를 결정하는 두 가지 지표를 정의하고, 이를 축으로 하는 Scenario Opportunity Map을 구축하여 기술 기회를 식별한다.
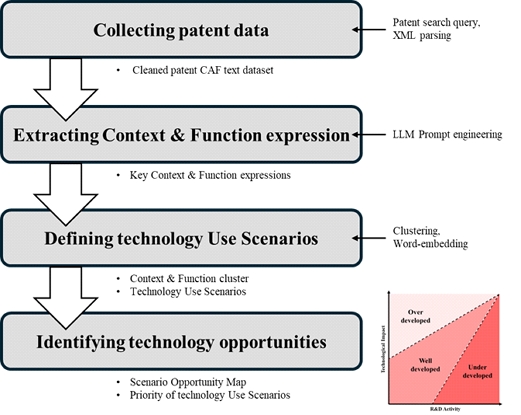
Overview of Analysis Framework
3.1 특허 데이터 수집
본 연구의 분석 방법은 연구 대상이 되는 특정 분야의 국내 특허 데이터 수집으로 시작된다. 먼저, 분석 대상 분야와 관련된 기술의 분류 코드나 기술적 키워드를 기반으로 특허 검색식을 작성한다. 이후 KIPRIS Plus(https://plus.kipris.or.kr) 또는 WIPS-ON(https://www.wipson.com)과 같은 공공/민간 특허 정보 서비스에서 특허 검색식을 통해 국내 특허를 검색할 수 있다. 검색 결과로 획득한 특허 목록에서, 분석에 필요한 출원 번호, 등록일, 피인용 문헌 수를 포함한 서지 정보를 수집한다.
또한, 본 연구에서는 특허 문서로부터 Context 및 Function 표현을 추출하기 위해 특허의 공통출원서식(Common Application Format, CAF) 항목 정보를 활용한다. CAF는 한국, 미국, 유럽, 일본 등 세계 주요 특허청 간에 발명의 내용을 담는 명세서, 청구 범위 등 출원 서식의 기재 순서 및 기재 항목을 국제적으로 통일화한 것이다. 2010년 이후 출원된 국내 특허 명세서는 <Figure 2>와 같이 항목에 맞춘 형태로 기술되어 있다(Park, 2010). 따라서 본 연구는 2010년 이후 국내에서 출원된 특허를 대상으로 CAF 항목별 텍스트 데이터를 수집한다.
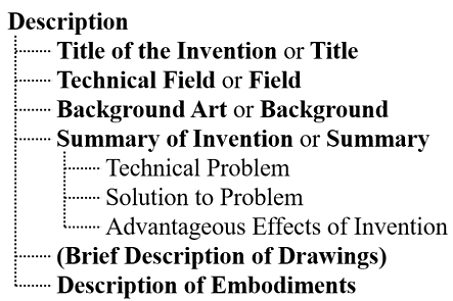
Structure of a Patent Document based on Common Application Format
3.2 Context 및 Function 표현 추출
본 단계에서는 수집한 CAF 항목 텍스트를 대상으로 Context 및 Function 표현을 추출한다. CAF 항목 ‘해결하려는 과제’는 발명이 다루고자 하는 근본적인 문제 상황과 기술 적용 배경을 기술하는 영역으로, 기술이 수행되는 Context 정보를 식별할 때 활용할 수 있다. 또한 ‘발명의 효과’ 항목은 발명을 통해 달성하고자 하는 목적과 기술적 성과를 명시적으로 제시하고 있어, 기술이 수행하는 Function 정보를 파악할 때 활용할 수 있다. ‘과제의 해결 수단’ 항목은 발명의 목적을 달성하기 위한 구체적인 기술의 구성을 담고 있는 영역으로, Function 정보를 파악할 때 역시 활용할 수 있다. ‘해결하려는 과제’ 항목에 포함된 Context 정보 및 ‘발명의 효과’ 항목에 포함된 Function 정보의 예시는 <Figure 3>과 같다.
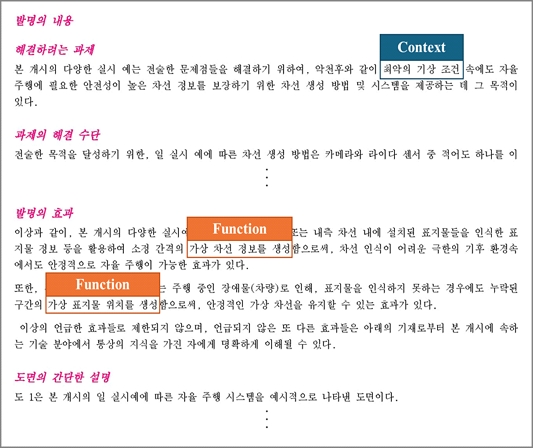
Examples of Context and Function Information Identified from Patent Documents (Korean Patent Application No. 1020240088798)
특허 명세서의 CAF 항목 텍스트는 분량이 방대하고 복잡하게 서술되어 있기 때문에, 원천 데이터를 그대로 사용하는 것은 분석의 용이성 측면에서 적합하지 않다. 따라서 본 연구는 CAF 항목 텍스트에서 분석에 필요한 Context 및 Function 표현만을 추출하여 분석에 활용한다. 이를 위한 수단으로는 NLTK(https://www.nltk.org), KoNLPy(https://konlpy.org) 등의 키워드 추출 라이브러리를 활용하거나, KeyBERT(https://github.com/MaartenGr/KeyBERT)와 같은 딥러닝 기반 모델을 활용하는 방법이 있다. 특히, Kim and Jang(2025)은 KoNLPy를 활용하여 한국어 특허 문서에서 기술 정보를 추출하는 Ko-SAO 방법론을 제안하였는데, 제안된 방법론은 기술의 Function 표현을 추출할 때 활용될 수 있다. 또한, 프롬프트 설계를 통해 대규모 언어 모델(Large Language Model, LLM)로부터 원하는 결과물을 도출하는 프롬프트 엔지니어링 기술을 활용하는 방법이 있다. 프롬프트 엔지니어링은 LLM의 문맥 이해 능력을 직접적으로 활용할 수 있어 복잡한 문장에서 핵심 정보를 식별하는 데 효과적이다. LLM의 응답 품질을 높이기 위한 프롬프트 엔지니어링 전략으로는 모델에 구체적인 역할을 부여하고, 복잡한 사고 과정을 단계별로 처리하도록 유도하며, 요구사항을 명확히 진술하고, 원하는 결과물의 예시를 제공하는 것이 있다(Bsharat et al., 2023). 설계한 프롬프트를 바탕으로 GPT, Claude, Llama 등의 LLM API를 활용해 CAF 항목의 문맥 정보를 기반으로 한 Context 및 Function 표현을 생성할 수 있다.
본 연구에서는 특허의 ‘해결하려는 과제’, ‘발명의 효과’ 항목을 통해 Context 및 Function 표현을 추출한다. 표현 추출 과정에서, ‘과제의 해결 수단’ 항목에서는 발명 전체의 본질적인 Function 이외에도 기술을 구현하기 위한 세부적인 과정에서의 부수적 Function 정보가 추출될 수 있다. 본 연구에서는 기술이 수행하는 근본적인 Function을 식별하고자 하여 ‘과제의 해결 수단’ 텍스트는 분석 대상에서 제외하였다.
3.3 기술 활용 시나리오 정의
본 단계에서는 클러스터링을 통해 유사한 특성을 갖는 Context 클러스터와 Function 클러스터를 쌍으로 연결하여 기술 활용 시나리오를 정의한다. 클러스터링은 방대한 양의 데이터에 존재하는 패턴이나 구조를 파악하여 유사한 속성을 공유하는 데이터들을 하나의 클러스터로 분류하는 비지도 학습 방법론이다. 클러스터링을 활용하면 복잡한 정보를 체계적인 분석 단위로 구조화함으로써 해석의 용이성을 확보할 수 있다(Jain et al., 1999). 클러스터링은 K-Means Clustering, DBSCAN, Hierarchical Clustering 등의 알고리즘을 통해 구현 가능하며, 이 중 K-Means Clustering은 연산이 복잡하지 않아 대용량 특허 데이터 처리에 효율적이며, 모든 데이터를 특정 클러스터에 할당하므로 정보 손실 없이 기술 활용 시나리오를 도출할 수 있다(Hartigan and Wong, 1979). 따라서 본 연구는 K-Means Clustering 알고리즘을 활용하여 Context 및 Function 클러스터를 형성한다.
본 연구는 K-Means Clustering 알고리즘을 적용하기에 앞서, Elbow Method를 활용하여 데이터의 특성을 잘 반영할 수 있는 최적의 클러스터 수(K)를 결정한다. 결정된 K값에 따라 Context, Function 표현에 대해 각각 K-Means Clustering 알고리즘을 적용하여 클러스터를 형성한다. 이후 Context 및 Function 클러스터 간의 관계를 연결하여 Context-Function 클러스터 쌍(Pair)을 구성하면, 각 쌍은 ‘특정 Context에서 기술이 어떠한 Function을 수행한다’라는 기술이 활용되는 하나의 시나리오의 의미를 가질 수 있다. 따라서 본 연구는 Context-Function 클러스터의 쌍을 ‘기술 활용 시나리오’로 정의한다(<Figure 4>). 단, ‘정차 중’ Context와 ‘긴급 제동’ Function과 같이 논리적으로 결합되지 않는 Context-Function 조합은 유의미한 시나리오로 보기 어려우므로, 본 연구는 연관 규칙 분석의 Support와 Lift 지표를 활용하여 결합력이 있는 Context-Function 클러스터 쌍을 찾아 연결한다(Han et al., 2022). 우선, Support는 전체 특허 중 특정 Context-Function 클러스터 조합을 구성하는 특허의 비율을 의미한다. Support의 수식은 식 (1)과 같다.
| (1) |
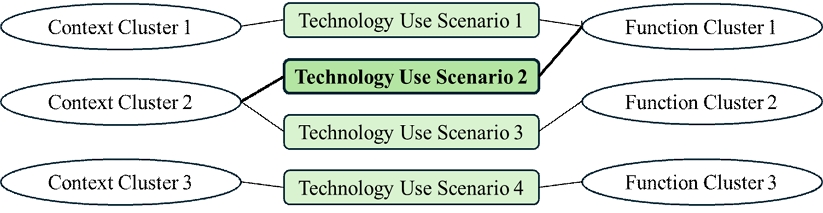
Defining Technology Use Scenarios by Linking Context-Function Clusters
식에서 N은 전체 분석 대상 특허 수를 의미하고, 특정 Context 클러스터 Ci와 Function 클러스터 Fj의 표현이 동시에 출현한 특허의 빈도수를 |Ci∩Fj|로 표기한다. 하나의 특허에서 특정 Context와 Function이 동시에 기술되었다는 것은 제시된 Function이 주어진 Context에 실제로 적용되어 문제를 해결할 수 있다는 것을 의미하므로, 특허의 동시 출현 빈도가 높은 Context-Function 클러스터 조합은 논리적으로 연결될 가능성이 높음을 뜻한다. 따라서, 본 연구는 파레토 법칙(Pareto Principle)에 근거하여 Support 상위 20% 이내 Context-Function 조합만을 선별한다.
다음으로, Lift는 두 클러스터 간 생성된 관계가 우연에 의한 것인지, 아니면 유의미한 상관관계에 기인한 것인지를 판별한다. Lift는 무작위로 Context-Function 조합을 연결했을 때의 확률 대비 실제로 두 클러스터의 표현이 동일한 특허에 동시 출현했을 확률의 비율로 계산되며, 수식은 식 (2)와 같다.
| (2) |
Lift가 1을 초과한다면, 두 클러스터가 무작위 조합보다 더 자주 동시 출현한다는 의미이므로 두 Context와 Function 클러스터가 유의미한 결합 관계가 있음으로 해석할 수 있다. 본 연구는 Support와 Lift 두 조건을 모두 만족하는 기술 활용 시나리오를 기술 기회 후보로 간주한다.
3.4 기술 기회 식별
본 단계에서는 정의된 기술 활용 시나리오 중 우선순위가 높은 기술 기회를 식별하기 위해 두 가지 평가지표 ‘R&D Activity’와 ‘Technological Impact’를 산출하고 Scenario Opportunity Map을 제시한다. R&D Activity는 시나리오에 투입된 자원과 관심의 수준을 나타낸다. 연구자와 기업이 주목하여 많은 특허가 출원된 시나리오는 산업계가 그 분야를 해결해야 할 중요한 과제로 인식하고 있음을 의미한다(Griliches, 1998). 본 연구는 R&D의 활동량을 산출하기 위해 얼마나 많은 특허가 특정 Context와 Function의 결합을 다루고 있는지를 측정한다. 구체적으로, 특정 시나리오의 Context 및 Function 클러스터에 동시에 표현이 속한 특허는 해당 시나리오를 대변하는 특허로 간주할 수 있으므로, 시나리오를 대변하는 특허의 수를 산출하여 R&D Activity 값으로 정의한다. R&D Activity의 계산식은 식 (3)과 같다.
| (3) |
다음으로, Technological Impact는 시나리오를 구현하는 기술의 기술적 발전 정도를 나타낸다. 이미 기술적으로 고도화된 시나리오는 새로운 기회로 보기 어려우므로, 본 연구는 시나리오를 대변하는 특허의 연평균 피인용 횟수 평균을 계산하여 기술적 파급력을 산출한다. 피인용 횟수는 기술의 영향력을 측정하는 지표로 널리 사용되며, 기간 대비 피인용 횟수가 높은 특허들은 해당 분야에 큰 영향력을 미치는 특허로 판단할 수 있다(Chung et al., 2021; Oh et al., 2019). 특허의 피인용 횟수는 시간에 따라 축적되는 성질이 있으므로, 연평균 피인용 횟수를 산출하면 기간과 관계없이 특허들의 영향력을 파악할 수 있다. 특정 시나리오를 구성하는 특허들이 큰 영향력을 미치고 있다는 것은 후행 기술의 파생이 충분히 이루어지고 있음을 나타내며, 이 경우 상대적으로 완성도 높은 기술 분야로 간주할 수 있다. Technological Impact 계산식은 식 (4)와 같다.
| (4) |
식에서 Citationp는 특허 p의 피인용 횟수이며, Agep는 특허 p의 경과 연수이다.
본 연구는 정의한 두 지표를 바탕으로 기술 활용 시나리오의 기회 수준을 산출하기 위해 Opportunity algorithm을 활용한다. Opportunity algorithm은 본래 고객 니즈의 순위를 도출하여 비즈니스 기회를 식별하고자 하는 알고리즘으로, 중요도가 높고 만족도가 낮은 고객 니즈를 기회로 정의한다(Jung et al., 2023). 본 연구에서는 R&D Activity가 높고 Technological Impact가 낮은 시나리오를 기술 기회로 정의하므로, Opportunity algorithm의 수식을 기반으로 기회 수준을 정량적으로 산출한다(식 (5)).
| (5) |
RAnorm과 TInorm은 최소-최대 정규화를 통해 0에서 10 사이의 범위로 환산한 R&D Activity와 Technological Impact이다.
본 연구에서 제시하는 Scenario Opportunity Map은 기술 활용 시나리오의 우선순위를 식별할 수 있는 시각적 분석 도구이다(<Figure 5>). Ulwick(2005)은 두 변수 간의 상대적인 격차에 주목하여 3개의 영역을 통해 기회 수준을 확인하는 Opportunity landscape 접근을 제시하였으며, Opportunity algorithm을 활용한 여러 선행 연구들은 주로 두 지표의 평균값을 기준으로 영역을 구분하였다(Jeong et al., 2019a; Jung et al., 2023). 본 연구의 Scenario Opportunity Map은 해당 이론적 배경을 근거로 하여, R&D Activity와 Technological Impact의 평균값을 기준으로 3개의 영역을 구분하였다. 두 지표의 평균값은 해당 기술 분야 전체 시나리오들의 중심 경향을 나타내며, 평균값을 향한 기준선을 통해 두 지표의 상대적인 불균형 정도를 시각적으로 식별할 수 있도록 한다. 각 영역이 갖는 의미는 R&D Activity와 Technological Impact 사이의 상대적 대소 관계에 따라 다음과 같이 설명된다. 우선 Under developed 영역은 R&D Activity가 높지만 상대적으로 Technological Impact가 낮은 영역이다. 해당 영역은 많은 연구자와 기업이 뛰어든 중요한 분야이지만, 아직 시장을 지배하는 압도적인 기술이 등장하지 않았을 가능성이 높은 영역이므로 기회 수준이 높다. Well developed 영역은 평균에 근접한 R&D Activity와 Technological Impact를 가진 시나리오들이 위치하고 있는 영역으로, 적절한 수준으로 발전되고 있는 영역이다. Over developed 영역은 상대적으로 R&D Activity보다 Technological Impact가 높은 영역으로, 타 영역에 비해 중요도 대비 기술적 완성도가 높은 분야이므로 진입할 가치가 낮은 영역이다. 각 시나리오의 정량적인 기회 수준은 Scenario Opportunity Map의 원의 크기로 반영되어 함께 식별할 수 있다. 본 연구는 Scenario Opportunity Map의 결과를 바탕으로 기술 활용 시나리오의 우선순위를 판별하는 시각적 근거를 제공한다.
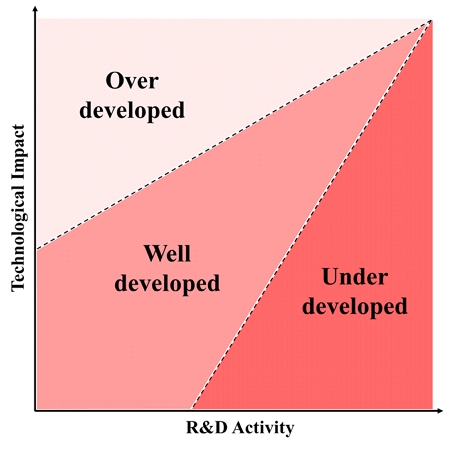
Scenario Opportunity Map
4. 사례연구: 국내 자율주행 자동차 기술
본 장에서는 국내 자율주행 자동차 산업의 특허를 대상으로 본 연구에서 제시한 연구 방법을 적용하는 사례연구를 진행한다. 자율주행차 기술은 센서, 제어, 통신, 인공지능 등 다양한 기술 요소가 결합되는 기술 중심 산업이며, 완성차 및 IT 기업, 부품 업체, 공공 연구 기관 등 다양한 주체가 활발히 R&D와 특허 출원을 수행하고 있다(Oh, 2025). 자율주행 분야는 스마트 시티를 주도하는 대표적인 모빌리티 기술로서 주목받고 있다(Parekh et al., 2022). 특히, 한국의 경우 2030년까지 미국·중국의 자율주행 기술을 따라잡기 위해 대규모의 R&D 기획을 추진하고 있다(Ministry of Trade, 2025). 따라서, 현 시점에서 R&D 전략의 방향성을 살펴보고자 본 연구의 사례 분야로 선정하였다.
4.1 특허 데이터 수집 및 전처리
본 연구는 다음과 같은 절차로 분석용 데이터셋을 구축하였다. 우선, WIPS-ON에서 출원 번호, 등록일, 피인용 문헌 수와 같은 서지 정보를 수집하였다. 자율주행 자동차 분야의 특허 수집을 위해 특허 검색식을 활용하였으며, 자율주행 관련 키워드와 자동차/전기차 관련 키워드가 2어절 이내에 함께 등장하는 것을 조건으로 검색식을 구성하였다(Kim, 2020). 본 연구에서 활용한 특허 검색식은 <Table 1>과 같다.

Patent Search Query for Autonomous Vehicle Technology
자율주행차 분야는 전 세계적으로 2016년부터 특허 출원이 급증하며 실용화 기술과 원천 기술이 균형 있게 발전하였다(Oh, 2025). 국내 특허의 경우 2019년을 기점으로 등록 건수가 눈에 띄게 증가하는 추세를 보였다. 따라서 본 연구는 국내 자율주행 자동차 분야의 기술 개발이 본격화된 시점인 2019년 이후 등록된 특허를 분석 대상으로 설정하였다. 특허 검색식을 통해 수집한 자율주행 자동차 분야의 연도별 국내 특허 등록 건수 통계는 <Table 2>와 같다.
Annual Trend of Granted Korean Patents for Autonomous Vehicle Technology
이후 KIPRIS API를 통해 호출된 XML 응답을 파싱하여 CAF 항목별 텍스트를 추출하였다. 본 연구에서는 CAF 항목 중 ‘해결하려는 과제’와 ‘발명의 효과’만을 활용하므로, 두 항목을 찾을 수 없거나 내용이 비어 있는 경우 분석에서 제외하였다. 이 과정을 통해 최종적으로 3,716건의 특허가 분석 데이터셋에 포함되었다.
4.2 Context 및 Function 표현 추출
본 연구에서는 구축한 특허 데이터셋에서 Context 및 Function 표현을 추출하기 위해 프롬프트 엔지니어링을 활용하였다. 프롬프트 엔지니어링 전략은 <Table A1>과 같이 구성하였다(Bsharat et al., 2023).
본 연구에서 제시하는 프롬프트 구조는 대규모 언어 모델의 추론 능력을 향상하고 분석의 일관성을 확보하기 위해 다음과 같은 구성 요소를 가진다. 우선 Role에서 역할을 부여하여 모델이 기술 분석 전문가의 관점에서 답변하도록 추론 범위를 한정하였다. 이어 Concepts & Definitions에서 Context와 Function의 정의를 명시함으로써, 모델이 본 연구에서 정의한 Context와 Function의 의미를 정확히 인지하여 텍스트를 해석하도록 하였다. Instructions를 통해 상세한 수행 지침을 설계하고, Output Rules에서 결과물의 형식과 제한 사항을 설정하였다. 마지막으로 Examples에서 특허 데이터의 유효성에 따라 원하는 결과물을 출력하도록 예시를 제공하고, Task를 통해 입력 데이터에 대해 실행을 명령하도록 설계하였다.
프롬프트를 바탕으로 Context 및 Function 표현을 추출할 때, 하나의 특허에 여러 Context 및 Function 정보가 존재할 수 있다. 이때 개수 상한 없이 표현을 생성하면, 부수적이거나 중복되는 정보들이 생성될 가능성이 존재한다. 예비 실험을 통해 표현의 수를 제한하지 않고 생성한 결과, 생성된 표현의 개수가 4개 이상인 특허의 경우에는 발명의 핵심 내용보다 하위 개념, 중복 내용이 섞이는 경우가 발생하였다. 따라서 본 연구에서는 분석의 용이성을 고려하여 최대 생성 개수를 3개로 제한하는 Output Rules를 정의하였다.
본 연구에서는 설계한 프롬프트의 범용적 성능을 검증하고, 최적의 언어 모델을 선별하기 위해 GPT-4.1, Llama 3, Claude Sonnet 4 모델을 대상으로 성능 비교 실험을 진행하였다. 이때, 실험의 재현성 확보를 위해 Temperature 및 Seed 파라미터를 고정하였다. Temperature는 언어 모델이 다음 단어를 예측할 때 부여하는 확률 분포를 조정하는 파라미터로, Temperature 값이 낮을수록 확률이 가장 높은 단어 하나만 선택할 가능성이 높아진다(Holtzman et al., 2019). Seed는 언어 모델이 확률 연산을 수행할 때 난수 생성의 경로를 결정하는 기준값으로, Seed 파라미터를 고정하면 모델이 매번 동일한 연산 과정을 따르게 되어 출력 결과의 변동성을 최소화하게 된다(Bethard, 2022). 본 연구에서는 세 모델에 대해 모두 Temperature 값을 0으로 고정하고, Seed 파라미터가 존재하지 않는 Claude Sonnet 4를 제외한 두 모델에 대해 Seed 값을 고정한 후 비교 실험을 진행하였다. 본 연구에서 진행한 성능 평가 방법은 다음과 같다. 우선 100건의 특허를 무작위로 샘플링한 후, CAF 항목 텍스트에 대해 직접 정답 Context, Function 표현을 라벨링한다. 이후 정답 표현과 프롬프트를 기반으로 LLM이 생성한 표현 간의 코사인 유사도를 산출하여 Precision, Recall 값을 정의한다. 모든 샘플의 Context 및 Function 표현에 대해 평균 Precision/Recall을 계산하면 F1-Score를 도출할 수 있다. 각 지표 산출 수식은 식 (6)~(8)과 같이 정의된다.
| (6) |
| (7) |
| (8) |
식에서 N은 전체 특허의 개수를 의미하며, Ti와 Mi는 각각 i번째 특허에 대한 정답 표현 집합과 생성된 표현 집합을 나타낸다. 또한, 함수 cos(m,t)는 생성된 표현 m과 정답 표현 t 사이의 코사인 유사도를 의미한다. 본 연구에서는 언급한 방법을 통해 모델마다 성능을 평가하였으며, 모델별 성능 비교 결과는 <Table 3>과 같다.
Performance Evaluation Results of Context and Function Expression Extraction by Model
성능 비교 실험 결과, 설계한 프롬프트가 세 모델에 대해 일관성 있게 준수한 성능을 보였으며, 본 연구에서는 그중 가장 좋은 성능을 보인 GPT-4.1을 사례연구 대상 모델로 채택하였다.
GPT-4.1 기반 프롬프트 엔지니어링을 통해, 수집한 특허 데이터 중 실질적인 기술 정보가 아닌 형식적인 문구로 구성된 7건을 제외한 3,709건의 특허에 대해 Context 표현 7,792개, Function 표현 8,572개가 생성되었다. 추출한 Context 및 Function 표현의 예시는 <Table 4>에 나타내었다.
Examples of Extracted Context and Function Expressions
4.3 기술 활용 시나리오 정의
앞서 추출한 Context 및 Function 표현을 기술 활용 시나리오로 정의하기 위해 클러스터링을 수행하였다. 우선, 클러스터링 품질을 저하시키는 노이즈를 제거하기 위해, 범용적인 단어들을 도메인 불용어로 정의하여 제거하였다. ‘자동차’, ‘시스템’, ‘차량’과 같은 표현은 분야 특성상 매우 빈번하게 등장하기 때문에, 클러스터링 알고리즘이 구체적인 기술적 특징이 아닌 범용적 단어를 기준으로 클러스터를 형성하는 현상이 발생할 수 있다. 따라서 본 연구는 Context에서 ‘자동차’, ‘시스템’, ‘상태’, ‘차량’, Function에서 ‘제어’, ‘차량’, ‘제공’, ‘기능’을 제거하였다. 완전히 동일한 키워드가 중복되어 벡터 공간의 차원을 불필요하게 증가시키는 문제를 방지하기 위해 중복 표현은 하나로 병합하였다. 이후 전처리한 키워드를 고차원 벡터로 변환하기 위해 한국어 문장 임베딩에 특화된 사전 학습 모델 jhgan/ko-sroberta-multitask(https://huggingface.co/jhgan/ko-sroberta-multitask)를 선정하여 활용하였다. 해당 모델은 sentence-transformer 라이브러리를 통해 구현되며, 각 표현의 의미적 유사성을 보존하는 벡터를 생성할 수 있게 한다.
다음으로, K-Means Clustering 알고리즘을 적용하기 전 최적의 클러스터 수(K)를 결정하기 위해, K값 증가에 따른 Inertia의 변화 추이를 관찰하는 Elbow Method를 적용하였다. Inertia는 각 클러스터의 중심점과 해당 클러스터에 속한 개별 데이터 포인트 간의 거리 제곱합으로, Inertia 값이 작을수록 클러스터가 더욱 명확하게 이루어짐을 의미한다. K가 증가함에 따라 Inertia 감소 폭이 급격히 줄어드는 지점을 식별하기 위해, Inertia의 감소율이 5회 연속 임계치 이하로 유지되는 구간의 시작점을 최적의 K로 결정하는 규칙을 적용하였다. 이를 통해 Context 클러스터 수 21개, Function 클러스터 수 26개로 결정되었으며(<Figure 6>), scikit-learn(Version 1.5.2; https://scikit-learn.org) 라이브러리를 활용하여 K-Means Clustering을 수행하였다.
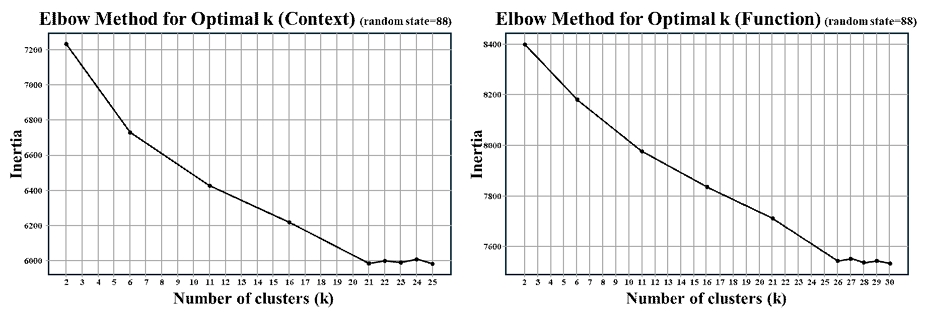
Determination of the Optimal Number of Clusters via Elbow Method
클러스터링 후, 각 클러스터의 특성을 명확히 정의하기 위해 각 키워드 벡터와 클러스터의 중심점 간의 유클리드 거리를 계산하였다. 이를 기준으로 중심점과 거리가 가까운 순서대로 키워드를 정렬하여, 클러스터를 대표하는 주요 키워드를 식별하였다. 클러스터링 결과는 <Table A2> 및 <Table A3>에 제시하였다.
Context 및 Function 클러스터를 구성하는 키워드의 수가 많은 클러스터는 전체 특허 데이터 내에서 활발하게 다루어지는 주류 연구 주제임을 나타낸다. Context 클러스터 중 키워드 수가 가장 많은 클러스터는 ‘외부 환경(C4)’과 ‘도로 교통 환경(C13)’으로 나타났다(<Table 5>). 해당 결과는 악천후 조건이나 혼잡한 도심 교차로와 같은 특정 Context에서의 기술이 많이 논의되고 있음을 뜻한다. ‘자율주행 운용(C8)’의 키워드 수가 많은 것은 자율주행 모드 활성화, 주행 중에 발생하는 다양한 이벤트 처리 등 실제 운용 상황에 대한 기술 개발이 활발함을 뜻한다. 종합적으로, Context 측면에서 현재 자율주행 분야는 복잡한 실제 운용 상황에서 안전하고 편리하게 운용될 수 있는 자율주행 기술의 R&D 활동이 활발함을 보여준다.
Top 5 Context Clusters by Number of Keywords
Function의 경우 ‘시스템 성능 검증 및 시뮬레이션(F9)’이 가장 많은 키워드 수를 가진 클러스터로 나타났다(<Table 6>). 해당 결과는 자율주행 기술 개발 과정에서 규제 당국과 소비자의 신뢰를 얻기 위한 검증 단계가 중요하게 여겨지고 있음을 보여준다. ‘주행 공간 관리 및 통제(F15)’는 주변 차량과의 안전거리 확보, 차선 유지, 장애물 회피 등 동적 환경에서 안전하게 기동하는 능력을 의미하며, ‘경로 계획 및 최적화(F4)’는 목적지까지 효율적이고 안전한 경로를 탐색하는 내비게이션 능력을 의미한다. 위 두 Function은 자율주행의 두뇌에 해당하는 소프트웨어 스택이며, 이에 대한 기술 고도화 작업이 활발히 이루어지고 있음을 알 수 있다.
Top 5 Function Clusters by Number of Keywords
이후 도출된 Context-Function 클러스터 중 Support 및 Lift 조건을 만족하는 기술 활용 시나리오를 선별하였으며, 총 546개의 Context-Function 쌍 중 93개의 쌍이 기술 기회 후보로 도출되었다.
4.4 Scenario Opportunity Map 구축 및 기술 기회 시나리오 식별
본 연구는 기술 활용 시나리오의 기회 수준을 판별하기 위해 모든 시나리오에 대해 R&D Activity와 Technological Impact를 산출하였다. 최종적으로 산출된 Opportunity Score의 평균은 2.394이며, 가장 높은 Opportunity Score를 가진 시나리오는 ‘C8-F9(자율주행 운용-시스템 성능 검증 및 시뮬레이션)’이었다. 도출된 전체 시나리오의 Opportunity Score는 <Table A4>에 나타내었다.
식별된 기술 활용 시나리오와 각 시나리오의 R&D Activity 및 Technological Impact, 그리고 Opportunity Score를 통해 Scenario Opportunity Map을 구축하였다(<Figure 7>). Scenario Opportunity Map의 각 원은 기술 활용 시나리오이며, 원의 크기는 Opportunity Score에 비례한다. Under developed 영역에는 시나리오의 R&D Activity에 비해 Technological Impact가 낮은, 즉 기회 수준이 높은 시나리오들이 분포되어 있으며, 총 13개의 시나리오가 도출되었다.
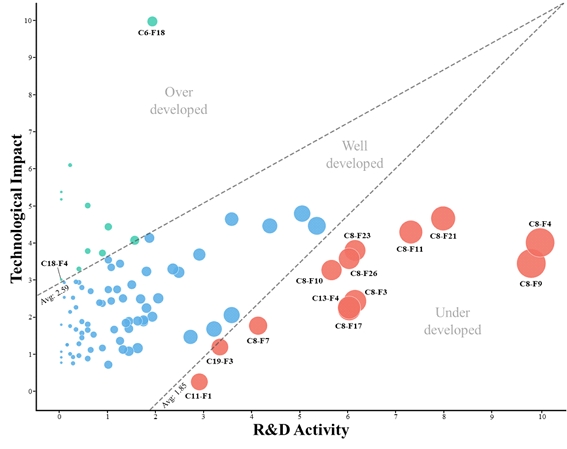
Scenario Opportunity Map for Autonomous Vehicle Technology
자율주행 자동차 기술 분야의 기술 개발 방향은 우선순위가 가장 높은 Under developed 영역에 위치한 시나리오를 통해 해석할 수 있다. 우선, Opportunity Score가 가장 높았던 기술 활용 시나리오는 ‘C8-F9(자율주행 운용-시스템 성능 검증 및 시뮬레이션)’이었다. C8-F9 시나리오는 Context와 Function의 개별적인 측면에서도 주목할 만한 결과를 보여주었다. ‘자율주행 운용(C8)’은 Under developed 영역 내 13개의 시나리오 중 약 77%에 해당하는 10개의 시나리오에 포함된 Context였으며, ‘시스템 성능 검증 및 시뮬레이션(F9)’은 키워드 수가 가장 많은 Function 클러스터였다. C8-F9 시나리오에 포함된 2025년 등록 특허 「PG(Proving Ground) 기반 VILS(Vehicle-In-the-Loop Simulation) 테스트를 위한 시뮬레이션 장치 및 이의 시뮬레이션 방법」은 실제 차량과 가상 객체를 연동한 VILS 기술을 통해 현실을 기반으로 한 자율주행 검증 시뮬레이션 시스템을 제안하였다(출원번호: 1020230048279). 해당 특허 예시에서 확인할 수 있듯, C8-F9 시나리오는 자율주행 시스템이 다양한 운용 조건에서 의도대로 작동하는지 확인하는 검증 과정을 의미한다. 자율주행 기술이 고도화될수록 더욱 많은 주행 변수나 돌발 상황에 대한 안전성을 확보하는 것은 필수적이다. 실제로 많은 운전자가 완전 자율주행의 안전성에 대한 우려를 표출한다(Jeong et al., 2019b). 그러나, 실제 도로 주행만으로 검증하는 것은 물리적 비용과 안전상의 한계를 수반한다(Kalra and Paddock, 2016). 이미 Waymo나 Tesla와 같은 선도 기업이 주도하는 미국 시장의 경우, 방대한 주행 데이터를 기반으로 안정적인 시스템을 운용하고 서비스를 최적화하는 운용 단계에 도달해 있다(Chen et al., 2024). 그러나 한국의 경우 자율주행 분야 선도국 대비 주행 데이터가 부족하다는 점을 극복하기 위해, 가상 환경에서 실제 환경을 최대한 유사하게 구현할 수 있는 시뮬레이션 시스템 개발이 필요할 것이다.
또한, Context-Function 조합 측면에서 ‘C8-F4(자율주행 운용-경로 계획 및 최적화)’ 시나리오가 가장 높은 R&D Activity 값을 도출하였다. 시나리오 내에 존재하는 현대자동차의 특허 「자율주행차량의 경로 보상 장치 및 그 방법」은 DNN(Deep Neural Network)을 기반으로 자율주행 중 구간별 정상 경로 패턴과 비정상 경로 패턴들을 학습하고, 비정상 경로 패턴을 대상으로 센서의 가중치를 변경하며 획득한 보상 경로 패턴 학습을 통해 다양한 주행 환경에 최적화된 경로를 제공하는 기술을 제시하였다(출원번호: 1020190059206). 특허 예시처럼, C8-F4 시나리오는 자율주행을 실제로 운용하고 있는 Context에서 차량이 내부적으로 최적의 경로를 탐색하는 Function을 의미한다. 자율주행 중 최적의 경로를 탐색하는 것은 정해진 목적지로 빠르고 편안하게 도착하기 위한 내비게이션 능력만을 가리키는 것이 아니라, 자율주행 중 갑자기 발생하는 장애물에 대처하거나, 제동이나 조향 측면에서 탑승자에게 편안한 승차감을 제공하는 주행 궤적을 판단하는 것과 같은 Function을 포함한다(González et al., 2015). 해당 시나리오는 탑승자의 안전과 승차감, 비용의 효율 등 자율주행 기술 개발의 많은 목표와 직접적으로 연결되어 있으므로, 여러 목표를 동시에 만족할 수 있는 기술을 개발하려는 접근이 필요할 것이다.
C8-F4와 동일한 Function을 수행하는 시나리오 ‘C13-F4(도로 교통 환경-경로 계획 및 최적화)’ 또한 Under developed 영역에 위치하였다. C13-F4 시나리오에 포함된 특허의 예시로, 현대자동차의 「자율주행차량 및 그의 유턴 경로 생성 방법」 특허는 자율주행 차량이 U턴 구간을 주행할 때, 차량의 선회 특성을 고려하여 최적의 유턴 경로를 산출하는 기술이다(출원번호: 1020190135558). C13-F4 시나리오는 C8-F4 시나리오와 Function 클러스터가 동일하지만, 특허 예시에서 확인할 수 있듯이 ‘U턴 구간’과 같은 특정 도로 환경에서 최적의 경로를 탐색하는, 다른 의미의 Function이 된다. Function이 동일한 또 다른 시나리오 ‘C18-F4(탑승자 이동 및 승하차-경로 계획 및 최적화)’는 우선순위가 낮은 Over developed 영역에 위치하는 것을 고려할 때, 같은 Function을 수행하는 기술일지라도 Context에 따라 기회 수준이 크게 달라질 수 있음을 확인할 수 있다.
Under developed 영역에서 Technological Impact가 가장 낮았던 시나리오는 ‘C11-F1(공정 및 작업 현장-차체 구조 최적화 및 강성 확보)’로 나타났다. 자율주행차는 기존 차량 대비 차량 내부에 수많은 센서, 컴퓨팅 장치 등이 추가로 탑재되므로 전체적으로 중량이 증가하는 경향이 있다. 특히, 미래 자율주행차의 표준 아키텍처가 될 전기차의 경우 차량 하부에 배터리 팩이 탑재되므로 기존 내연기관차 대비 중량이 크게 증가한다(Bösch et al., 2018). 시나리오 내 특허인 「전기차용 배터리유닛의 장착연결장치」는 알루미늄 차체 프레임과 철제 배터리 유닛 간의 결합 문제를 해결하여 차체를 경량화할 수 있는 장착 연결장치를 제안하였다(출원번호: 1020190060424). 자동차의 중량은 연비 및 가속 성능 등에 직접적인 영향을 주기 때문에 차체를 경량화하면서도, 강성 또한 확보하는 설계 기술이 중요하게 평가되고 있다(Czerwinski, 2021). 그러나 C11-F1 시나리오의 Technological Impact가 매우 낮다는 것을 고려할 때, 차체의 강성 수준을 확보하면서 무게를 줄이는 기술의 개발이 현재 효과적으로 이루어지지 않고 있다고 해석할 수 있다. 따라서 기업 및 연구 기관은 이를 해결하기 위한 기술을 개발할 수 있다. 예를 들어, 새로운 소재를 도입하거나 이종 소재의 결합을 고려할 수 있으며, 자율주행 차량에 최적화된 차량 구조를 설계하고자 하는 노력이 필요하다.
Over developed 영역은 Technological Impact가 높고 R&D Activity가 낮은 시나리오들이 위치하며, 일반적으로는 추가적인 R&D 투자의 기회 수준이 낮다고 판단된다. 그러나 Over developed 영역의 시나리오는 기술 개발 방향을 성능 향상이 아닌 새로운 가치로 전환하는 데 둠으로써, 기존 기술을 새롭게 정의하는 파괴적 혁신의 기회로도 해석할 수 있다(Jung et al., 2023). Over developed 영역에 속하는 대표적인 시나리오는 ‘C6-F18(주행 제어 상황-차량 제동 시스템 제어)’로, 평균보다 3.86배 높은 Technological Impact를 도출했다. C6-F18 시나리오에 속한 현대자동차의 특허 「자율주행 차량용 페달 조작 안전장치」는 자율주행 모드 시 페달을 베이스 패널 내부의 수납 홈으로 회전시켜 은폐함으로써 운전자의 오조작을 물리적으로 차단하고, 운전자에게 휴식 공간을 제공하는 메커니즘을 제안하였다(출원번호: 1020160069568). 특허 예시와 같이, C6-F18 시나리오는 대부분 자율주행 자동차의 제동이나 페달과 관련된 기술들로 구성되어 있다. 제동이나 페달과 관련된 기술은 기술적으로 비교적 완성도가 높은 상태로 해석할 수 있으므로, 더욱 좋은 성능의 기술을 개발하기보다 효율적이거나 저렴한, 또는 구조가 단순한 기술을 개발하려는 접근이 필요하다. 예를 들어 페달의 무게나 원가를 획기적으로 절감하거나, 복잡한 제동 장치를 단순하게 설계하는 방향을 고려할 수 있다.
5. 결 론
본 연구는 특허 문서로부터 기술의 Function과 기술이 적용되는 Context를 함께 분석하여 시나리오 단위로 기술 기회를 발굴하는 새로운 방법을 제시하였다. 가장 먼저 국내 특허 데이터를 수집하였으며, LLM 기반 프롬프트 엔지니어링을 통해 특허의 CAF 텍스트로부터 Context 및 Function 표현을 추출하였다. 다음으로, 클러스터링을 거쳐 Context-Function 클러스터를 연결함으로써 기술 활용 시나리오를 정의하였으며, 도출된 시나리오의 기회 수준을 평가하기 위해 R&D Activity와 Technological Impact라는 두 가지 지표를 산출하고, 이를 바탕으로 Scenario Opportunity Map을 구축하여 우선순위를 식별하였다. 자율주행 자동차 기술 분야를 대상으로 한 사례연구 결과, 3,709건의 특허 데이터로부터 총 21개의 Context 클러스터와 26개의 Function 클러스터가 도출되었으며, Scenario Opportunity Map 분석을 통해 R&D Activity는 높으나 Technological Impact가 상대적으로 낮은 Under developed 영역의 시나리오들을 식별할 수 있었다.
본 연구는 TOD 분야에 있어 다음과 같은 이론적, 실무적 기여점을 가진다. 이론적 측면에서, 본 연구는 기술의 Function과 더불어 Context를 함께 분석하는 새로운 방법론을 제시하고, ‘기술 활용 시나리오’라는 독창적인 분석 단위를 개발하였다. 이를 통해 기존의 Function 중심 TOD 연구가 다루지 못했던 Context 정보를 포함하여 기술 기회 탐색의 범위를 확장했다는 의의가 있다. 또한, 본 연구는 R&D의 활동량과 기술적 파급력을 동시에 고려하는 기술 기회 식별의 새로운 시각을 제시하여, Context에 따라 변화하는 기술 기회의 우선순위를 식별할 수 있는 방법론을 정립하였다. 실무적 측면에서, 본 연구의 기술 활용 시나리오 단위 분석은 기술의 실질적인 활용처와 적용 Context를 구체적으로 제시하여 실제 R&D 및 사업 전략 수립 시, 보다 명확한 기술 개발 방향을 설정하는 데 기여할 수 있다. 특히, 본 연구에서 제안한 Scenario Opportunity Map은 산업 내 불필요한 경쟁을 피하고 실질적인 기술적 돌파구가 필요한 영역을 선점하는 분석적 근거로서 활용될 수 있다. 마지막으로, 본 연구는 데이터 추출부터 클러스터링, 매핑에 이르는 전 과정을 재현 가능한 절차로 정립하였다. 따라서 다양한 산업 분야의 기술기획 실무자들이 유망 기술 시나리오를 탐색하는 데 폭넓게 활용할 수 있을 것으로 기대된다.
그러나, 본 연구는 향후 개선될 수 있는 한계점이 존재한다. 첫째, 본 연구는 국내 특허 데이터만을 분석 대상으로 하였기에 글로벌 기술 트렌드를 온전히 반영하지 못하였다. 향후 연구에서는 USPTO, EPO 등 분석 대상 국가를 확대하여 글로벌 단위의 기술 기회를 식별할 필요가 있다. 둘째, 본 연구에서는 LLM을 활용한 정보 추출 시 생성할 표현의 개수를 일률적으로 최대 3개 제한하였으므로 일부 복잡한 특허의 경우 세부적인 Context나 Function 정보가 누락되었을 가능성을 배제할 수 없다. 향후 연구에서는 특허의 청구항 수나 내용의 길이에 따라 추출 개수를 유동적으로 조절하거나, 더욱 정교한 프롬프트 엔지니어링을 통해 정보 손실을 최소화할 수 있는 방안을 모색할 수 있다. 셋째, 특허 인용 정보는 출원 후 일정 시간이 경과해야 축적되는 특성이 있으므로, 기술의 파급력을 측정함에 있어 피인용 횟수를 활용하는 접근은 최신 기술의 잠재적인 파급력을 즉각적으로 반영하기 어렵다는 한계가 있다. 향후 연구에서는 시장 보고서 등 외부 데이터를 결합하여 기술적 파급력을 보완적으로 측정하는 지표 개발이 이루어질 수 있다. 마지막으로, 본 연구는 생성된 Context 및 Function 표현의 타당성을 정량적인 지표만을 활용하여 검증하였다. 분석 대상 분야의 전문가 그룹을 통한 정성적 평가를 병행하여, 생성된 Context 및 Function 표현을 더욱 심도 있게 검증하는 후속 연구가 필요하다.
References
- Bethard, S. (2022), We need to talk about random seeds, arXiv preprint arXiv:2210.13393, .
-
Bösch, P. M., Becker, F., Becker, H., and Axhausen, K. W. (2018), Cost-based analysis of autonomous mobility services, Transport Policy, 64, 76-91.
[https://doi.org/10.1016/j.tranpol.2017.09.005]

- Bsharat, S. M., Myrzakhan, A., and Shen, Z. (2023), Principled instructions are all you need for questioning llama-1/2, gpt-3.5/4, arXiv preprint arXiv:2312.16171, .
-
Cammarano, A., Varriale, V., Michelino, F., and Caputo, M. (2024), Discovering technological opportunities of cutting-edge technologies: A methodology based on literature analysis and artificial neural network, Technological Forecasting and Social Change, 209, 123811.
[https://doi.org/10.1016/j.techfore.2024.123811]
-
Chen, L., Wu, P., Chitta, K., Jaeger, B., Geiger, A., and Li, H. (2024), End-to-end autonomous driving: Challenges and frontiers, IEEE Transactions on Pattern Analysis and Machine Intelligence.
[https://doi.org/10.1109/TPAMI.2024.3435937]
-
Chung, J., Ko, N., and Yoon, J. (2021), Inventor group identification approach for selecting university-industry collaboration partners, Technological Forecasting and Social Change, 171, 120988.
[https://doi.org/10.1016/j.techfore.2021.120988]
-
Czerwinski, F. (2021), Current trends in automotive lightweighting strategies and materials, Materials, 14(21), 6631.
[https://doi.org/10.3390/ma14216631]
-
González, D., Pérez, J., Milanés, V., and Nashashibi, F. (2015), A review of motion planning techniques for automated vehicles, IEEE Transactions on Intelligent Transportation Systems, 17(4), 1135-1145.
[https://doi.org/10.1109/TITS.2015.2498841]
- Griliches, Z. (1998), Patent statistics as economic indicators: a survey. In R&D and productivity: The econometric evidence (pp. 287-343). University of Chicago Press.
- Han, J., Pei, J., and Tong, H. (2022), Data mining: Concepts and techniques, Morgan kaufmann.
-
Hartigan, J. A. and Wong, M. A. (1979), Algorithm AS 136: A k-means clustering algorithm, Journal of the royal statistical society. series c (applied statistics), 28(1), 100-108.
[https://doi.org/10.2307/2346830]
- Holtzman, A., Buys, J., Du, L., Forbes, M., and Choi, Y. (2019), The curious case of neural text degeneration, arXiv preprint arXiv:1904.09751, .
-
Jain, A. K., Murty, M. N., and Flynn, P. J. (1999), Data clustering: A review, ACM Computing Surveys (CSUR), 31(3), 264-323.
[https://doi.org/10.1145/331499.331504]
-
Jeong, B., Yoon, J., and Lee, J.-M. (2019a), Social media mining for product planning: A product opportunity mining approach based on topic modeling and sentiment analysis, International Journal of Information Management, 48, 280-290.
[https://doi.org/10.1016/j.ijinfomgt.2017.09.009]
-
Jeong, M., Lee, S. C., Chang, H. S., and Ji, Y. G. (2019b), A Study on Differences in Driver’s Acceptance of Partially and Fully Automated Vehicles, Journal of the Korean Institute of Industrial Engineers, 45(5), 402-415.
[https://doi.org/10.7232/JKIIE.2019.45.5.402]
-
Jung, J., Lee, J., and Yoon, J. (2023), Service Opportunity Discovery Via Review Mining of Meal Kit Delivery Service, Journal of the Korean Institute of Industrial Engineers, 49(2), 142-156.
[https://doi.org/10.7232/JKIIE.2023.49.2.142]
-
Kalra, N. and Paddock, S. M. (2016), Driving to safety: How many miles of driving would it take to demonstrate autonomous vehicle reliability? Transportation Research Part A: Policy and Practice, 94, 182-193.
[https://doi.org/10.1016/j.tra.2016.09.010]
- Kim, B. (2020), Trend of Patent for EV Wireless Charging, AUTO JOURNAL : Journal of the Korean Society of Automotive Engineers, 42(12), 66-70. http://www.dbpia.co.kr/journal/articleDetail?nodeId=NODE10495680
-
Kim, J. and Lee, S. (2024), Technology Opportunity Analysis for Creating Innovative Solutions: Applying Semi-supervised Topic Modelling on Patent Data, 2024 Portland International Conference on Management of Engineering and Technology (PICMET).
[https://doi.org/10.23919/PICMET64035.2024.10653159]
-
Kim, M., Park, H., Sawng, Y.-W., and Park, S.-Y. (2019), Bridging the gap in the technology commercialization process: Using a three-stage technology–product–market model, Sustainability, 11(22), 6267.
[https://doi.org/10.3390/su11226267]
-
Kim, S. and Jang, H. (2025), Ko-SAO Structure for Functional Analysis of Korean Patents in Energy Field, Journal of the Korean Institute of Industrial Engineers, 51(2), 194-200.
[https://doi.org/10.7232/JKIIE.2025.51.2.194]
-
Lee, J., Jeong, B., Yoon, J., and Song, C. H. (2023), Context-aware customer needs identification by linguistic pattern mining based on online product reviews, IEEE Access, 11, 71859-71872.
[https://doi.org/10.1109/ACCESS.2023.3295452]
-
Lee, J., Kim, C., and Shin, J. (2017), Technology opportunity discovery to R&D planning: Key technological performance analysis, Technological Forecasting and Social Change, 119, 53-63.
[https://doi.org/10.1016/j.techfore.2017.03.011]
-
Lee, J., Ko, N., Yoon, J., and Son, C. (2021), An approach for discovering firm-specific technology opportunities: Application of link prediction to F-term networks, Technological Forecasting and Social Change, 168, 120746.
[https://doi.org/10.1016/j.techfore.2021.120746]
- Lee, W., Kim, K., and Ko, B. (2011), Functions and economic effects of a technology opportunity discovery system, Journal of Korea Technology Innovation Society, 14(spc), 1096-1127.
- Ministry of Trade, I. A. E. M. (2025), Opening the future of K-mobility innovation. https://www.motir.go.kr/kor/article/ATCL3f49a5a8c/171195/view#
-
Moon, S. and Lee, H. (2024), Identifying technological opportunities using enhanced tech mining: The case of the E-health industry, Technological Forecasting and Social Change, 206, 123561.
[https://doi.org/10.1016/j.techfore.2024.123561]
-
Mun, C., Yoon, S., Raghavan, N., Hwang, D., Basnet, S., and Park, H. (2021), Function score-based technological trend analysis, Technovation, 101, 102199.
[https://doi.org/10.1016/j.technovation.2020.102199]
- Oh, J.-E. (2025), Patent trends in the autonomous vehicle field, Journal of the Korean Institute of Communications and Information Sciences (Information and Communications), 42(3), 31-35.
-
Oh, S., Jeong, B., Ko, N., Choi, J., Lee, J.-M., Coh, B.-Y., and Yoon, J. (2019), Development of Patent Information-based Indexes for Product Innovativeness Analysis, Journal of the Korean Institute of Industrial Engineers, 45(1), 11-21.
[https://doi.org/10.7232/JKIIE.2019.45.1.011]
-
Parekh, D., Poddar, N., Rajpurkar, A., Chahal, M., Kumar, N., Joshi, G. P., and Cho, W. (2022), A review on autonomous vehicles: Progress, methods and challenges, Electronics, 11(14), 2162.
[https://doi.org/10.3390/electronics11142162]
-
Park, H., Seo, W., Coh, B.-Y., Lee, J.-M., and Yoon, J. (2014), Technology Opportunity Discovery Based on Firms’ Technologies and Products, Journal of the Korean Institute of Industrial Engineers, 40(5), 442-450.
[https://doi.org/10.7232/JKIIE.2014.40.5.442]
-
Park, H., Yoon, J., and Kim, K. (2013), Using function-based patent analysis to identify potential application areas of technology for technology transfer, Expert Systems with Applications, 40(13), 5260-5265.
[https://doi.org/10.1016/j.eswa.2013.03.033]
-
Park, I. and Yoon, B. (2018), Technological opportunity discovery for technological convergence based on the prediction of technology knowledge flow in a citation network, Journal of Informetrics, 12(4), 1199-1222.
[https://doi.org/10.1016/j.joi.2018.09.007]
- Park, J.-S. (2010), Five leading patent offices, Invention & Patent, 35(10), 30-35.
-
Paula, F. D. O. and Silva, J. F. D. (2021), R&D spending and patents: levers of national development, Innovation & Management Review, 18(2), 175-191.
[https://doi.org/10.1108/INMR-11-2019-0142]
-
Qiao, Y., Zhang, S., and Chen, L. (2025), Discovering potential application areas for technologies using function-based SAO semantic analysis: A systematic framework, IEEE Transactions on Engineering Management, 72, 855-872.
[https://doi.org/10.1109/TEM.2025.3543354]
-
Ree, J. J., Jeong, C., Park, H., and Kim, K. (2019), Context–Problem Network and Quantitative Method of Patent Analysis: A Case Study of Wireless Energy Transmission Technology, Sustainability, 11(5), 1484.
[https://doi.org/10.3390/su11051484]
-
Ren, H., Zhang, L., and Wang, Q. (2023), A general methodology for technology opportunity discovery based on opportunity evaluation and optimization, IEEE Transactions on Engineering Management, 71, 6725-6740.
[https://doi.org/10.1109/TEM.2023.3262257]
-
Ren, H. and Zhao, Y. (2021), Technology opportunity discovery based on constructing, evaluating, and searching knowledge networks, Technovation, 101, 102196.
[https://doi.org/10.1016/j.technovation.2020.102196]
-
Roh, T., Jeong, Y., Jang, H., and Yoon, B. (2019), Technology opportunity discovery by structuring user needs based on natural language processing and machine learning, PloS one, 14(10), e0223404.
[https://doi.org/10.1371/journal.pone.0223404]
-
Roh, T., Jeong, Y., and Yoon, B. (2017), Developing a methodology of structuring and layering technological information in patent documents through natural language processing, Sustainability, 9(11), 2117.
[https://doi.org/10.3390/su9112117]
-
Song, B., Luo, J., and Wood, K. (2019), Data-driven platform design: patent data and function network analysis, Journal of Mechanical Design, 141(2).
[https://doi.org/10.1115/1.4042083]
-
Song, K., Kim, K. S., and Lee, S. (2017), Discovering new technology opportunities based on patents: Text-mining and F-term analysis, Technovation, 60, 1-14.
[https://doi.org/10.1016/j.technovation.2017.03.001]
- Ulwick, A. (2005), What customers want (Vol. 8), McGraw-Hill Professional Publishing New York, NY.
-
Wang, J., Ding, Z., Liu, Z., and Feng, L. (2024), Technology opportunity discovery based on patent analysis: A hybrid approach of subject-action-object and generative topographic mapping, Technology Analysis & Strategic Management, 36(9), 2070-2083.
[https://doi.org/10.1080/09537325.2022.2126306]
-
Yoon, J., Park, H., Seo, W., Lee, J.-M., Coh, B.-Y., and Kim, J. (2015), Technology opportunity discovery (TOD) from existing technologies and products: A function-based TOD framework, Technological Forecasting and Social Change, 100, 153-167.
[https://doi.org/10.1016/j.techfore.2015.04.012]
Appendix
부록
Prompt for Context and Function Expression Extraction
Context Clustering Result
Function Clustering Result
Opportunity Scores of 93 Technology Use Scenarios
양희찬: 건국대학교 산업공학과에서 2026년 학사 학위를 취득하고, 건국대학교 산업공학과 석사과정에 재학 중이다. 주요 연구 분야는 Intellectual property data analytics for technology planning이다.
김민규: 건국대학교 산업공학과에서 2025년 학사 학위를 취득하고, 건국대학교 산업공학과 석사과정에 재학 중이다. 주요 연구 분야는 Patent analytics for technology planning, Language model-based expert system for speech-language rehabilitation processes이다.
이승현: 건국대학교 산업공학과에서 2021년 학사 학위, 2026년 박사 학위를 취득하고, 현재는 삼일회계법인 AX Node에서 AI Scientist/Consultant로 재직 중이다. 주요 연구 분야는 Web & Patent data analytics for social problem-solving R&D, Natural language processing for business intelligence, Data-driven prognostics and health management이다.
설영진: 건국대학교 산업공학과에서 2021년 학사 학위를 취득하고, 건국대학교 산업공학과 석박사통합과정에 재학 중이다. 주요 연구 분야는 Computational patent analytics for technology opportunities, Technology recommendation method and system, Machine & Deep learning-based system for industrial processes이다.
윤장혁: POSTECH 산업공학과에서 학사, 석사 학위를 취득한 후, LG CNS에서 4년간 재직하였으며, POSTECH 산업경영공학과에서 박사 학위를 취득하였다. 한국지식재산연구원을 거쳐 현재는 건국대학교 산업공학과 정교수로 재직 중이다. 주요 연구 분야는 대량 데이터 분석 기반의 Business intelligence, Patent analytics, Social media analytics, Industrial artificial intelligence, Healthcare data analytics이다.